はじめに
福岡で AI による業務改善や自動化、Web 制作などに取り組んでいる Trellis です。
会議もチャットも案件資材も、ぜんぶ Obsidian に貯めて「コンテキストを途切らせない」。その運用を2本に分けて書いていて、これは貯めた文脈を引き出す つかう編 です。
ためる編では、発生源をまるごと外部脳に貯める仕組み(PARA のフォルダ、Copilot での議事録生成、自分の発言記録、グラフビュー)を書きました。やっていることの正体は コンテキストエンジニアリング です。つまり「AI が正しく判断できる文脈を、途切れさせずに設計・維持する」ことです。
コンテキストを途切らせないObsidian術(ためる編): 会議もチャットも、AIが読める外部脳に貯めるスマホで開く
でも、貯めただけでは、ただのゴミ屋敷です。
このつかう編では、貯めた外部脳から AI でどう引き出し、自分自身の振り返りにどう返すか を書きます。
案件名や顧客名はマスキングしていますが、仕組みはすべて実物です。
「昨日のあれ」を、曖昧なまま引き出す
AIに「先月のあの件」が伝わる仕組み
外部脳の価値が出たのは、AI に曖昧な聞き方ができるようになってからでした。
「ここ1ヶ月の To Do で、こんなことがあった気がするんだけど」。
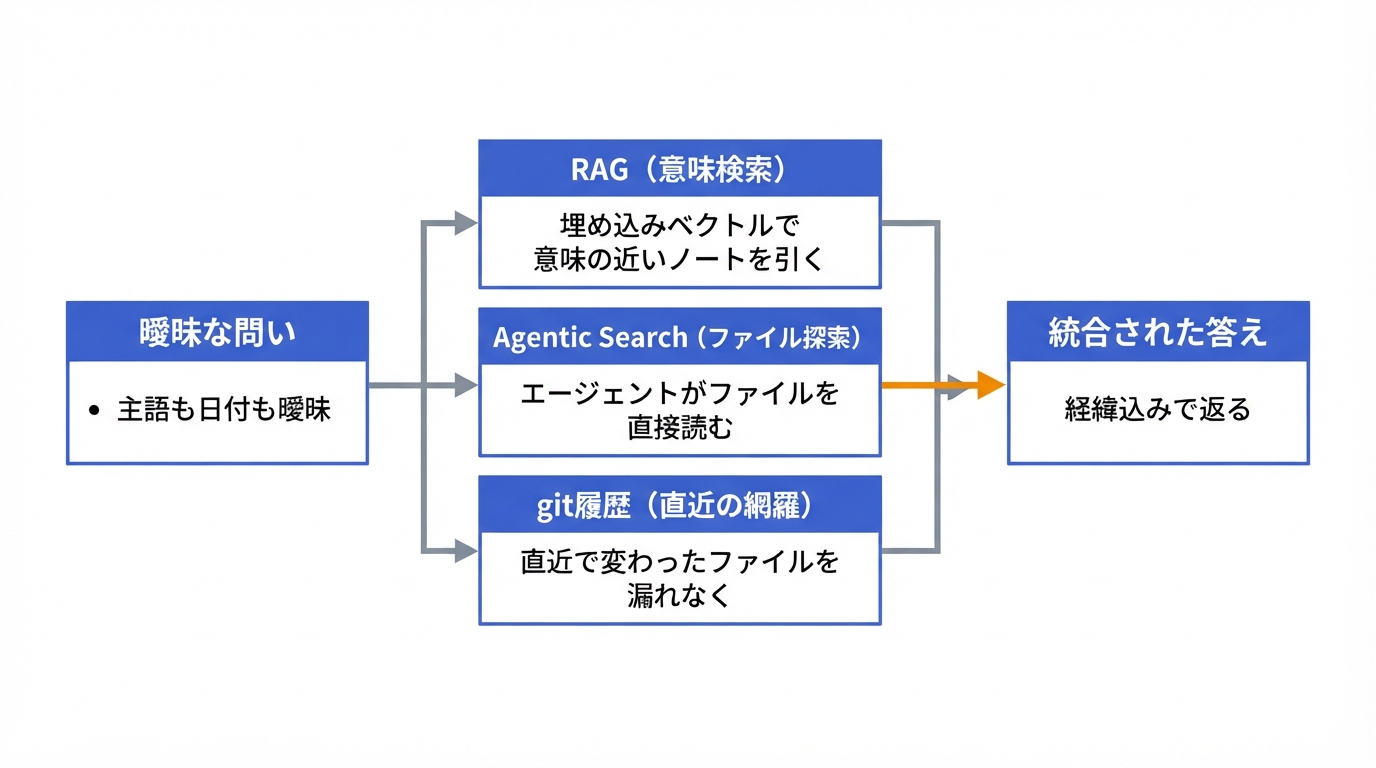
主語も日付も曖昧なこの問いに、経緯込みで答えが返ってきます。
最初は「高精度な RAG を入れれば解決する」と思っていました。
でも、単一の RAG だけだと外れます。
要約が浅かったり、直近の差分に弱かったり、表記ゆれを拾えなかったり。
そこで、RAG 単体ではなく、 エージェントによる検索(Agentic Search)と RAG を組み合わせたハイブリッドサーチ に切り替えました。性質の違う3つの引き出し方を、AI がその場で使い分けて重ねます。
- RAG(意味検索) — エージェントがローカルの埋め込みベクトル(約6,000ノート分)を引いて、意味の近いノートを高速に見つける。「言葉は違うが意味は同じ」を拾う担当です
- Agentic Search(ファイル探索) — エージェントが自分で全文検索やフォルダ辿りを組み立て、ノートを直接読みにいく。RAG が取りこぼした周辺情報を、文脈を追いながら回収する担当です
- git 履歴(直近の網羅) — 「直近数週間に変更・追加された全ファイル」を git の履歴と未コミット差分から機械的に列挙する。日付を含まないファイル名や、まだコミットしていない新規ファイルという検索の死角を、時系列から潰す担当です
面白いのは、ここまで重ねると「明日やります」「対応しますね」といった、タスクの顔をしていない口約束まで拾えることです。ファイルを直接読みにいく Agentic Search が効いています。
意味の近さ(RAG)、文脈を追う探索(Agentic Search)、時系列の漏れなさ(git)。
この3つが重なって初めて、曖昧な問いに実用的な答えが返ってきます。
RAG を「入れるか入れないか」の二択で考えるのはやめて、 エージェントに、RAG も含む複数の検索を使い分けさせる 。この発想に落ち着きました。
日々のコミットログが、AIの「変更履歴」になる
3つ目の「git 履歴の網羅」を支えているのが、毎日のバックアップです。
毎晩、.bat で Vault 全体を自動コミット&プッシュしています。
これはただの退避ではありません。
本質は、 毎日コミットログが残る ことです。
「その日、どのノートがどう変わったか」が git の履歴に刻まれるので、AI は後から「この1週間の変更」を漏れなく辿れます。
バックアップを「消えないための保険」ではなく、「AI が読む変更履歴」として設計している。
ここが、地味ですが効いているポイントです。
仕組みの話は、ここまでです。
ここからは、この外部脳を毎日どう引き出しているかを、実際の使い方で見せます。前半で触れた3つの検索も、毎日はこうやって呼び出しています。
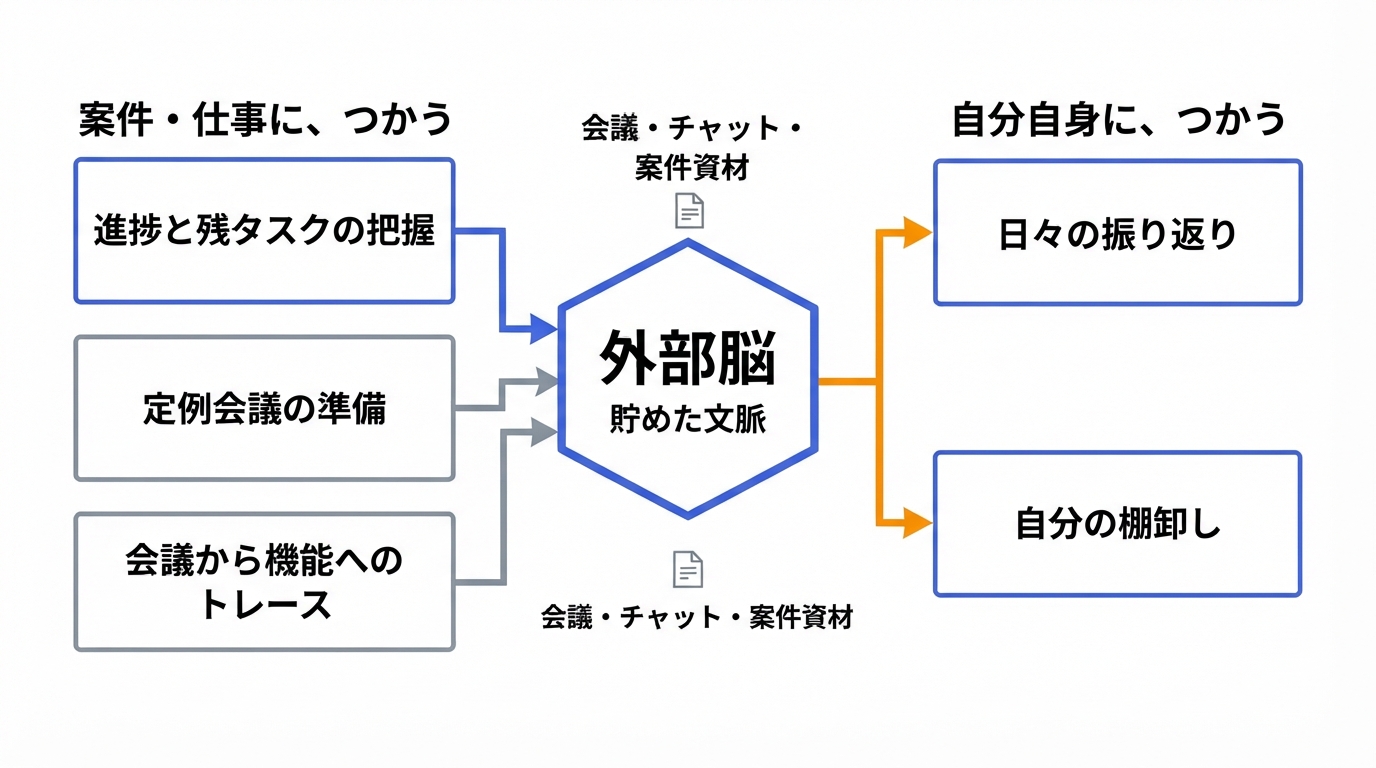
大きく分けると、 案件・仕事に、つかう ものが3つ、 自分自身に、つかう ものが2つです。
案件・仕事に、つかう
まずは、仕事まわりから。案件の状況把握、会議の準備、そして要件のトレース。この3つです。
進捗と残タスクの把握
引き出し方は、曖昧な質問だけではありません。
よく使う定型の問いは、スラッシュコマンドやスキルにして、繰り返し呼んでいます。
vault-search— Smart Connections の意味検索を先にかけ、足りなければ全文検索で補う二段構えの検索スキル。「どこかに書いたはず」を最短で手繰り寄せます。progress-report— 案件名を渡すと、その案件のフォルダ・議事録・チャットを横断で集めて、進捗・直近の動き・残 TODO を1枚のレポートにまとめてくれる。会議前の状況把握が、一瞬で終わります。check-task-leakage— 直近2週間の議事録・チャット・デイリーノートを突き合わせて、「デイリーノートに書き忘れたタスク」をあぶり出す。さきほどの git 完全網羅と意味照合の合わせ技で、口約束レベルの抜け漏れまで拾います。
この3つ目の抜け漏れ検出は、検索の「死角」を git で潰しているのが肝です。中身を少しだけ見せます。
実際の /check-task-leakage ワークフロー(案件名・パスはマスキング)
## 1. 対象ファイルを機械的に網羅取得

# [A] コミット済みの変更ファイル(git diff)
OLDEST=$(git log --oneline --since="14 days ago" -- \
  "<Vault>/議事録" "<Vault>/チャット" "<Vault>/デイリーノート" \
  | tail -1 | cut -d' ' -f1)
git diff --name-only "${OLDEST}^"..HEAD -- \
  "<Vault>/議事録" "<Vault>/チャット" "<Vault>/デイリーノート"

# [B] 未コミット(untracked)の新規ファイル(git status)
#     ※ git diff には絶対に現れない
git status --short "<Vault>/議事録" "<Vault>/チャット" "<Vault>/デイリーノート" \
  | grep "^??" | sed 's/^?? //'

# → [A][B] 両方が「読むべきファイルの正解リスト」。
#   チャットログは週番号ファイル名(例 2026-03-W04.md)なので日付マッチでは拾えない。
#   未コミットの新規ファイルは git diff では拾えない。この2つの死角を git で潰す。

## 2. 全ファイルをAIが直接読んでタスクを推論抽出
- grep のキーワードフィルタはしない。ファイルを丸ごと読ませる
- 「明日やってみます」「了解です、〜しますね」のような会話的コミットまで検出する
- 抽出するタスク: 議事録TODOで自分が担当の行 / チャットの自己コミット / 他者からの明示的な依頼

## 3. 照合
- 抽出タスクとデイリーノートを照合する。表現が違っても意味的に同じなら「登録済み」とみなす

## 4. 報告
- 未記載の候補を「元ファイル・タスク・期限・優先度(🔴🟠🟡)」の表で出し、追記するか確認する
いずれも、外部脳が漏れなく貯まっているからこそ成り立つ「引き出し方」です。
なお、vault-search の中核にある Smart Connections(意味検索の仕組み)については、その中身も、貯めたノート同士を意味でつなぎ直して知識グラフを育てる使い方も、後日公開する Smart Connections 専用の記事でまとめて紹介する予定です。ここでは「引き出す道具のひとつ」として、名前だけ出しておきます。
定例会議の準備
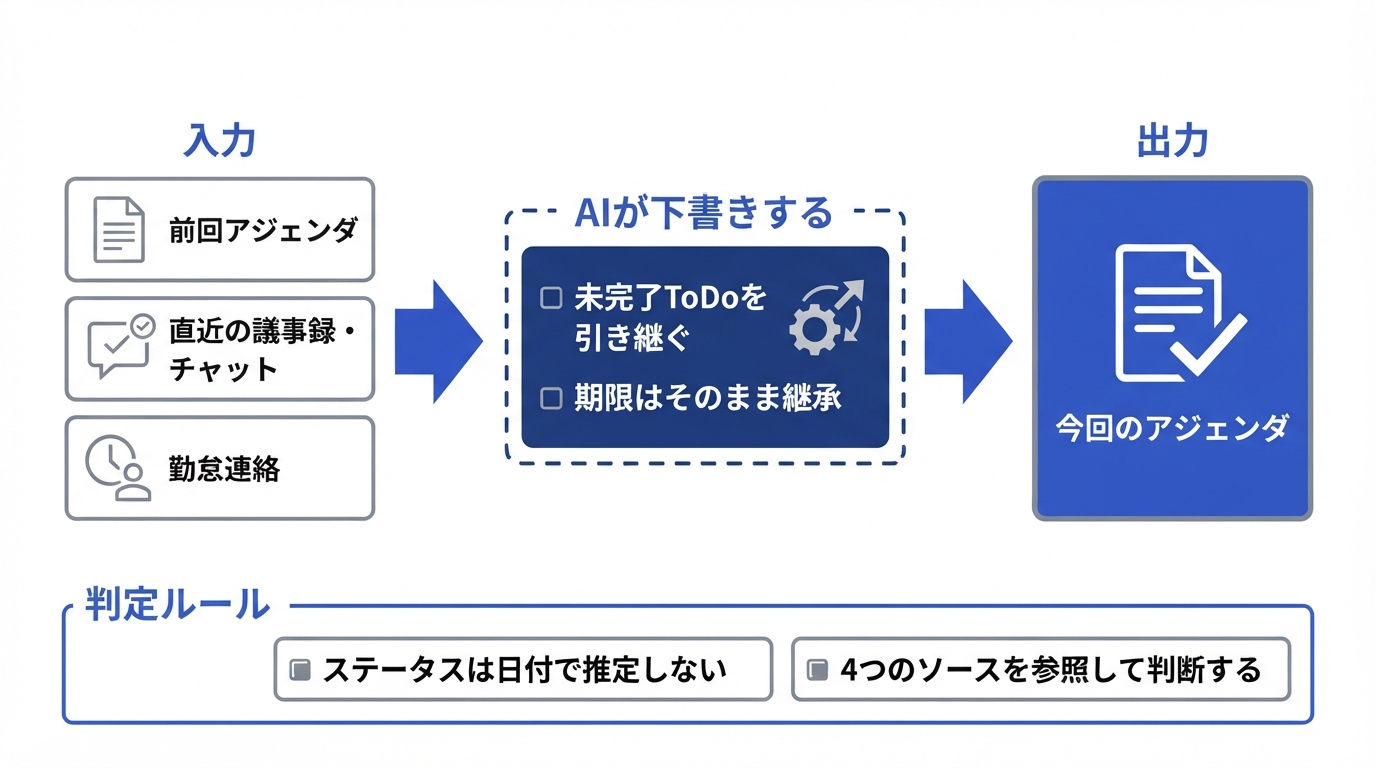
毎週の定例会議のアジェンダづくりも、AI に下書きさせています。
やらせているのは、こんな段取りです。前回のアジェンダと、直近の議事録・チャットを読ませて、未完了の ToDo を集め、担当と期限つきで今回のアジェンダに引き継ぐ。勤怠連絡もチャットログから拾って反映させます。
ここで一番効いているのが、ステータス判定のルールです。
ステータス(done / active / 未着手)は、日付だけで推定・決定してはならない。
必ず以下を優先順で参照して判断する:
  1. 前回アジェンダの完了チェック状況
  2. 会議チャットログ(最新週)
  3. 直近の議事録(前日・当日分)
  4. デイリーノート(前日・当日)
→ done にできるのは「完了が明示的に確認できたタスク」だけ
なぜ、ここまで細かく縛るのか。
AI は、空欄や曖昧なところを「それらしく」埋めるのが得意だからです。放っておくと「たぶん終わっているだろう」と、勝手に done を付けてしまう。だから「推測するな、ソースに当たれ」を明文化しています。
期限も同じで、 前回の値をそのまま引き継ぎ、過去の日付でも動かさない ようにしています。スケジュールのガント図も、マスターの週報から引いてステータスだけ更新し、開始・終了予定には触らせません。
これも、AI と共有したいルールを Markdown に書いて渡す、というためる編の考え方のそのままの応用です。会議の準備という毎週の作業が、ほぼ確認と微調整だけで終わるようになりました。
定例会議アジェンダ生成ワークフロー(案件名を伏せた抽象版)
## 1. 開催日の決定
- 保存先の最新アジェンダファイルの日付を基準に、翌営業日を算出する
- システム日付は使わない(必ずファイル日付から算出する)

## 2. 過去議事録からのTODO抽出
- 直近の定例会議の議事録を特定し、TODO(内容/担当/発生日/詳細)を抽出する

## 3. アジェンダ作成
- 最新アジェンダを複製し、日付・勤怠・完了タスクを更新する
- TODO をチーム・カテゴリ別に振り分ける
- 未完了タスクの継承:
    - 前回アジェンダで未完了(Done なし)のタスクをすべて引き継ぐ
    - Due は前回の値をそのまま引き継ぐ(過去日付でも動かさない)
- 勤怠: 会議チャットログの最新週から拾い、「午前休/午後休/早退」など
        いつ不在になるかが分かる表記にする(「午後出勤」のような曖昧表現は避ける)
- 期日は絶対表記(例: 6/15)。「来週」「中旬」などの相対表記は使わない

## 4. スケジュール(Mermaid ガント)
- マスター週報のガントを基準にし、変更するのはステータスだけ(done / active / 未着手)
- 開始・終了予定は、明確な指示があるまで動かさない
- ステータスは日付で推定しない。必ず次を優先順で参照する:
    1. 前回アジェンダの完了チェック
    2. 会議チャットログ(最新週)
    3. 直近の議事録(前日・当日)
    4. デイリーノート(前日・当日)
  → done にできるのは「完了が明示的に確認できたタスク」だけ

## 5. 完了報告
- 作成ファイルを提示し、前回からの差分(ガント変更・新規/完了タスク・勤怠更新)を報告する
会議から機能へのトレース
上流の仕事でいちばんしんどいのが、要件のトレーサビリティです。
「この機能は、どの会議のどの発言を起点に決まったのか」。
これを昔は Excel 1枚で管理していました。
やめました。そして、凝ったプラグインには乗り換えていません。いまやっているのは、 Markdown のテーブル(表)に、Obsidian の WikiLink([[...]])を並べるだけ です。
表の各行に「要件・機能」を1つ置き、そのセルから、根拠になった議事録・チャット・設計ノートへ WikiLink を張る。すると、表の1行が「会議 → 決定 → 要件 → 機能」の連鎖の入り口になります。あとはリンクをたどるだけで、その機能がどこから来たのかを遡れます。
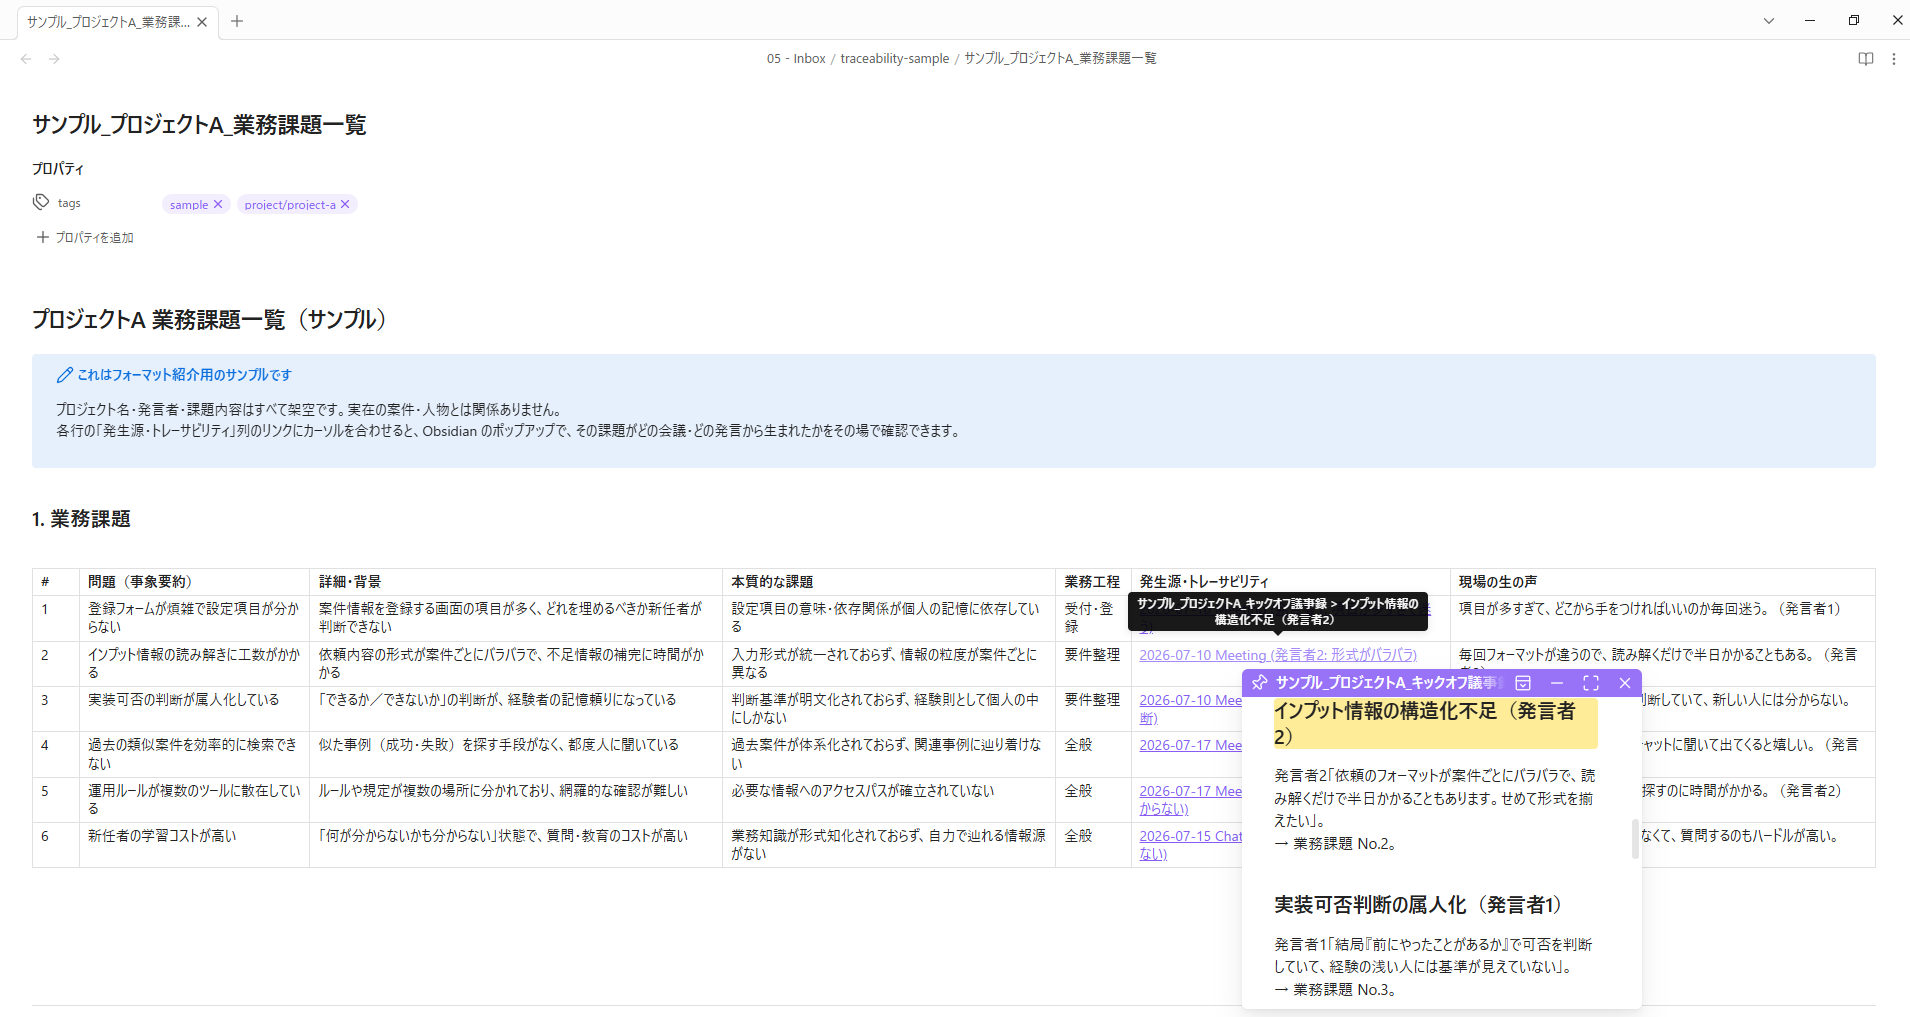
- 一覧で俯瞰する → Markdown の表(ただのテキストなので、AI もそのまま読める)
- 明細を確認する → Q&A 形式の Markdown ノート(「Q: この値の送信先は? A: …」の形で残す)
- 関係をたどる → WikiLink と3軸タグ
プラグインに頼らないのには、理由があります。 プレーンな Markdown なら、AI がそのまま読めて、壊れにくい からです。表もリンクもただのテキストなので、Vault ごと git で追えるし、エージェントも迷わず解釈できます。
ここで効くのが、ためる編で触れた「ソースを取り込む」運用です。
案件フォルダの 10_src/ に置いたソースの README へ、設計ノートからリンクを張る。
すると連鎖の終点が、実際のコードまで伸びます。10 - Projects/ 配下のリンクは、数えたら7,000本を超えていました。
自分自身に、つかう
引き出す相手は、案件だけではありません。
貯めた記録は、自分自身にも向けます。
日々の振り返り
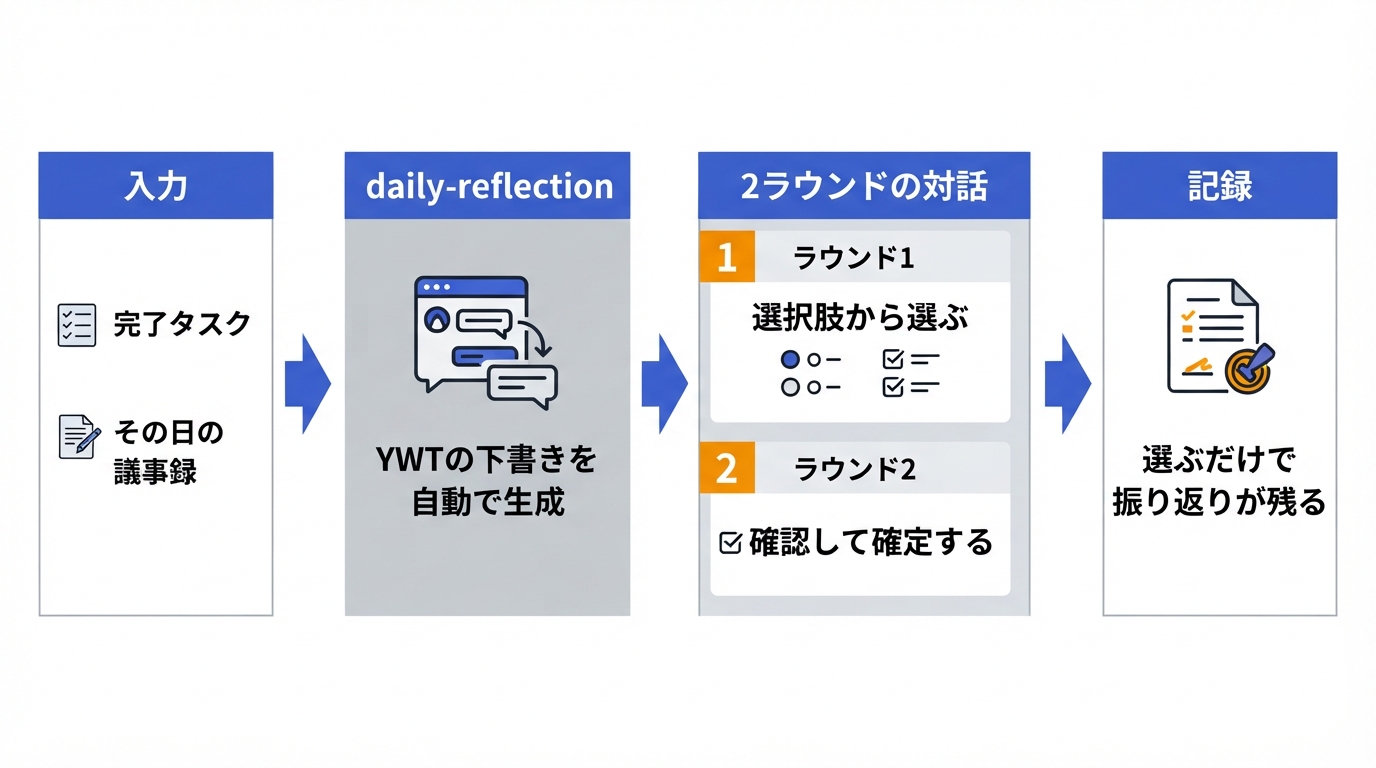
まずは、その日1日ぶんから。
その日のデイリーノートの YWT(やったこと/気づき/次にどうするか)は、空欄を自分で埋めません。/daily-reflection という スラッシュコマンド を走らせると、完了タスクとその日リンクした議事録を AI が読み、YWT の下書きを組み立ててくれます。
あとは選択肢が提示されるので、私は選ぶだけです。
さらに、その日のノートと議事録を対話形式のポッドキャスト音声に変換して、皿洗い中や寝かしつけ中に「ながら聴き」でも振り返ります(詳しくは別記事に書きました)。
「振り返るテンプレ」を持つのではなく、「振り返りが勝手に立ち上がる仕掛け」を持つ。
継続の最大の敵は、白紙の空欄だと思っています。
実際の /daily-reflection ワークフロー
## 1. 対象の日次ノートを特定し、「今日のTASK」を解析する

## 2. タスクを分類する
- 完了タスク: [x] が付いたもの
- 未完了タスク: [ ] のうち ==ハイライト== または **太字** のものだけ(プレーンは無視)

## 3. 関連コンテキストを深掘りする
- 日次ノート内の議事録リンク [[YYYY-MM-DD_...]] を読み、
  「どの会議に出て」「何が決まり」「自分がどう関与したか」を分析する

## 4. アラートロジック
- 未完了タスクは「N営業日目」を表示する(土日祝を除外)
- 🚨 条件: ハイライト(当日目標)が未チェック / 太字(ASAP)が4営業日目以上
- 装飾(== や **)はそのまま維持し、条件を満たせば末尾に 🚨 を付ける

## 5. 自動生成パート
- 「タスク消化実績(完了/未完了)」と YWT の枠を更新する
- Y の実績要約だけ自動で書き、W・T は空欄のまま残す

## 6. 対話的リフレクション(ここが本体)
- AskUserQuestion を2ラウンドで回す
    - ラウンド1(選択): その日の完了タスク・会議内容から選択肢を2〜3個
      +「スキップ」を提示する(フリー入力も可)
    - ラウンド2(確認・追記): 「『◯◯』として記録します。追記あれば入力」
      → 確定 / スキップ / 追記
- Y(工夫・挑戦)→ W(気づき・法則)→ T(次の一手)→ 未完了タスク の順で深掘りする
- 設計思想: 毎日続けられるよう負荷を最小化する。
  AI が選択肢を推論して出し、人は選ぶだけで記録できる状態にする
自分の棚卸し
ためる編で触れた「自分の発言記録」が、ここで効きます。
会議のたびに貯まった「自分がどう判断し、どう動いたか」を、週・月・年の単位でまとめて読み返す。
週次の振り返りは、/weekly-reflection に週フォルダを渡すだけです。
その週のデイリーノートを集計して、週報を組み立ててくれます。ただのコピペではなく、統合して要約・分析させているのがポイントで、効いている工夫がいくつかあります。
- 分報(雑多なメモ書き)は、集計から完全に外す。 ノイズになりやすいので、最初から読ませません。
- W(気づき)は、具体的な出来事から「再現性のある法則・セオリー」まで抽象化させる。 「今週こんなことがあった」で止めず、「だから次はこう動く」に変換させる、いちばん大事なパートです。
- その週の「ベスト・デシジョン」を1つ選ばせる。 いちばんインパクトのあった判断を振り返らせると、自分の勝ちパターンが見えてきます。
完了タスクはプロジェクト別に整理し、週をまたいだ残タスクは「繰り越し」として別枠に出す。
さらに、その週の議事録とノートをまとめた音声サマリーも生成して、週末のランニング中に聴いています。
読み返すと、いいことがあります。
- 自己分析 ができる(自分の判断の癖、強みと弱みが見えてくる)
- ネクストアクション につながる(次に何をすべきかが具体化する)
- 目標設定 の材料になる(過去の実績が具体的なので、目標が絵空事になりにくい)
プロジェクトのコンテキストだけでなく、自分自身のコンテキストも切らさない。
外部化する対象を「案件」から「自分」まで広げているのが、いまのやり方です。
うまくいっていないこと:つかう編の綻び
ここまで書くと順調そうですが、使う側にも綻びがあります。
しかも、 自分で「こう運用すべき」と決めた原則から、自分で外れている ものばかりです。
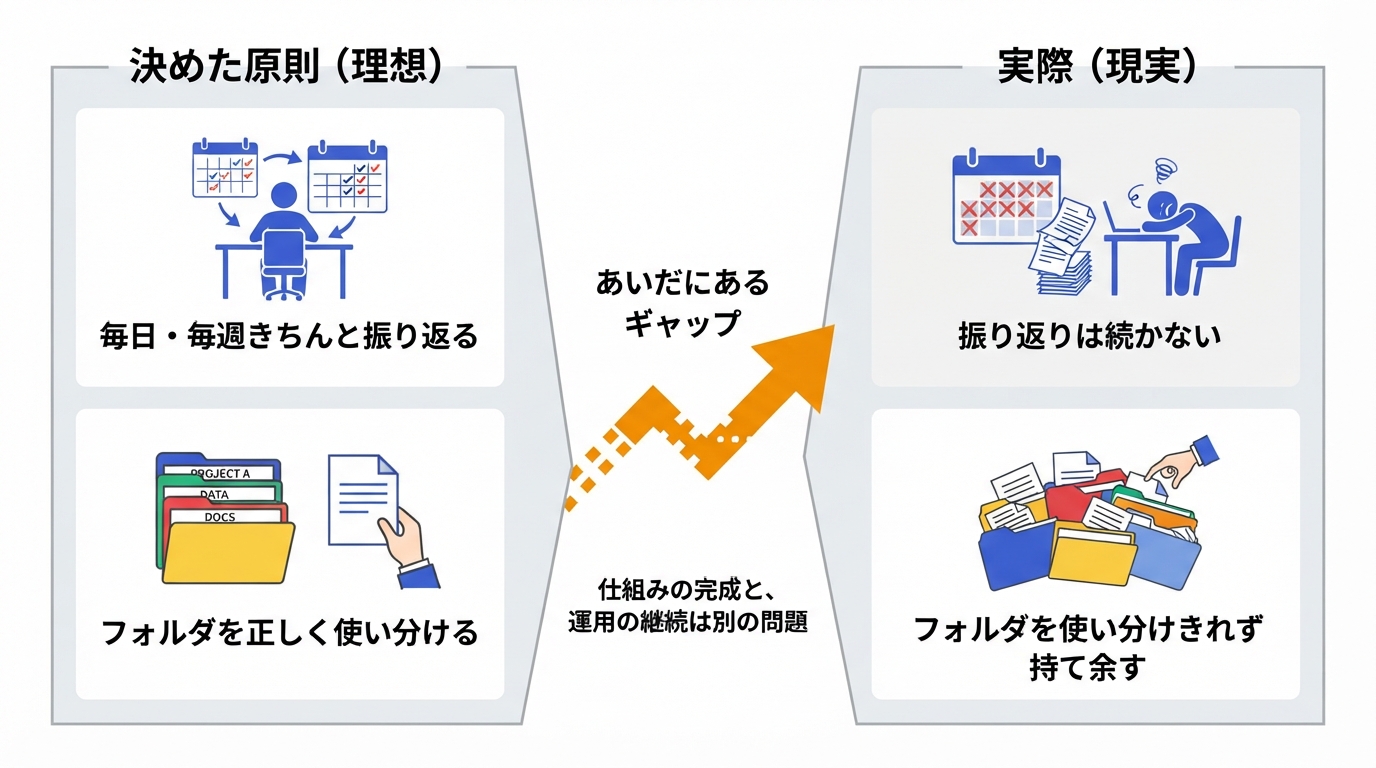
仕組みは作った。でも振り返りが続かない
朝のタスク設計は、完全に習慣化しました。
一方で、日次・週次の「振り返り」は、年始をピークに実行頻度が落ちています。
凝った仕組みほど、作り込んだ時点で満足してしまって、回すのを忘れます。
Obsidian をカスタマイズする人なら、身に覚えがあるのではないでしょうか。
自動化好きにありがちな 「無理・無駄・ムラ」の"ムラ" が、そのままデータに出ています。
どれだけ仕組みを整えても、それを思想どおりに使い続けられるかは、まったく別の話でした。
仕組みの完成度と、運用の継続は、別の問題だったんです。
Areas と Resources のフォルダを、使い分けきれていない
PARA には、Projects と DailyNotes のほかに、 Areas(20 - Areas:継続的な責任範囲・関心分野) と Resources(30 - Resources:参照資料) というフォルダがあります。
この2つは、いまも使い分けが手探りです。
案件フォルダと日次ノートは毎日触るのに、Areas と Resources は「どこに何を置くのが正解か」を決めきれず、うまく回せていません。
全部のフォルダをきれいに埋めることが目的ではないので放置していますが、宝の持ち腐れ感は否めません。
むしろ大事なのは、この「原則と現実のズレ」を直視して、ときどき調整することだと思っています。完璧な運用を目指すより、そのほうが長続きします。
あなたの Vault の Inbox は、いま空になっていますか?
おわりに
コンテキストを途切らせない運用にしてから、頭のなかが明らかに軽くなりました。
「あの件どうだったっけ」で議事録を漁る時間が消え、会議の直前に AI から文脈を引き出せます。
そして AI は「なぜこの機能が生まれたのか」に、特定の議事録や誰かの発言をソースとして答えてくれます。
前編・後編を通して、真似するなら順番があります。
高度な検索や自動化からではなく、 発生源を1か所に貯めること から始めてください。
フォルダを PARA で切り、会議とチャットを流し込む。それだけで、AI に渡せる文脈が貯まりはじめます。
そしてもうひとつ。
AI と共有したいルールやワークフローは、会話で毎回言わずに、CLAUDE.md やスラッシュコマンドという「消えない Markdown」に書いて渡すことです。
発生源を貯めることと、共有事項をファイルにすること。
この2つだけで、AI は驚くほど文脈を持ったまま動いてくれます。
流れて消えていくチャットの決定事項を、あなたの現場ではどう残していますか?
コンテキストは、途切れさせなければ、あとから AI がいくらでも繋ぎ直してくれます。
関連記事
無料で毎朝、自分専用のAIポッドキャストを全自動生成する仕組みを作った──NotebookLM × Claude Codeスマホで開く
AIの「頭の中」を可視化してみた:Nano Banana 2 Lite で思考を1枚の図にするスマホで開く
Trellis のこと
Trellis は、福岡でホームページの制作と、AI による業務の自動化に取り組んでいます。
記事は Zenn と、Trellis のサイトのブログの両方に載せています。