Claude Code のスキル(作業の手順をまとめた SKILL.md)を、大きく作り直しました。
354 行の手順書を 79 行に削り、別のスキルに分かれていた検証を、手順の最後にまとめています。
4 分の 1 の長さになっても精度は落ちず、むしろ上がっています。
どこまで削るかは、寝ているあいだにエージェントに探させました。
精度は高く、プロンプトの量は少なく。その開きがいちばん大きい版を、「削っては測る」のくり返しで見つけています。
福岡で AI による業務改善や自動化、Web 制作などに取り組んでいる Trellis です。
この記事で分かるのは、次の 3 つです。
- スキルの何を残し、何を削り、何をまとめたか
- 精度をどう測り、削っても落ちないと確かめたか
- 夜のあいだに「削っては測る」をエージェントに任せたときのプロンプト
スキルを削ると決めた理由
Claude Code のスキルとは
Claude Code は、Anthropic が提供する AI コーディングエージェントです。
ターミナル上でファイルを読み書きし、コマンドを実行しながら作業を進めます。
Claude Code のスキルは、ある作業のやり方をまとめたフォルダです。.claude/skills/<スキル名>/ に置き、中心となる手順書の SKILL.md と、必要なときだけ読む補助のファイルやスクリプトで構成します。
SKILL.md の先頭には名前と説明を書き、Claude は依頼に合うスキルを選んで読み込みます。
読み込まれたスキルの本文は、その後もコンテキストに残り続けます。
公式ドキュメントでも、1 行ごとに繰り返しトークン費用がかかるため、本文を簡潔に保つよう勧めています。
Keep the body itself concise. Once a skill loads, its content stays in context across turns, so every line is a recurring token cost.
(訳: 本文は簡潔に保つ。スキルが読み込まれると、その内容はターンをまたいでコンテキストに残るので、毎行が繰り返し発生するトークン費用になる。)
書き足し続けたスキル
見直したのは、業務で使っている、Figma のデザインから LP(キャンペーンなどの 1 枚のページ)を組むスキルです。
Figma のデザインを API 経由で取得し、決まったテンプレートと共通部品の上に HTML と SCSS で組みます。
テキストの網羅・lint・ビルドの確かめまでを、一連の工程に含んでいます。
最初の版から約 5 か月、指摘や事故が起きるたびにルールを 1 つずつ書き足してきました。
変更の記録 24 件のうち、減らす方向の変更は 3 件ほどにとどまります。
その結果、SKILL.md は 354 行・約 2 万字に膨らみ、関連する md と yaml が計 881 行、別に用意した検証のスキルが 201 行ありました。
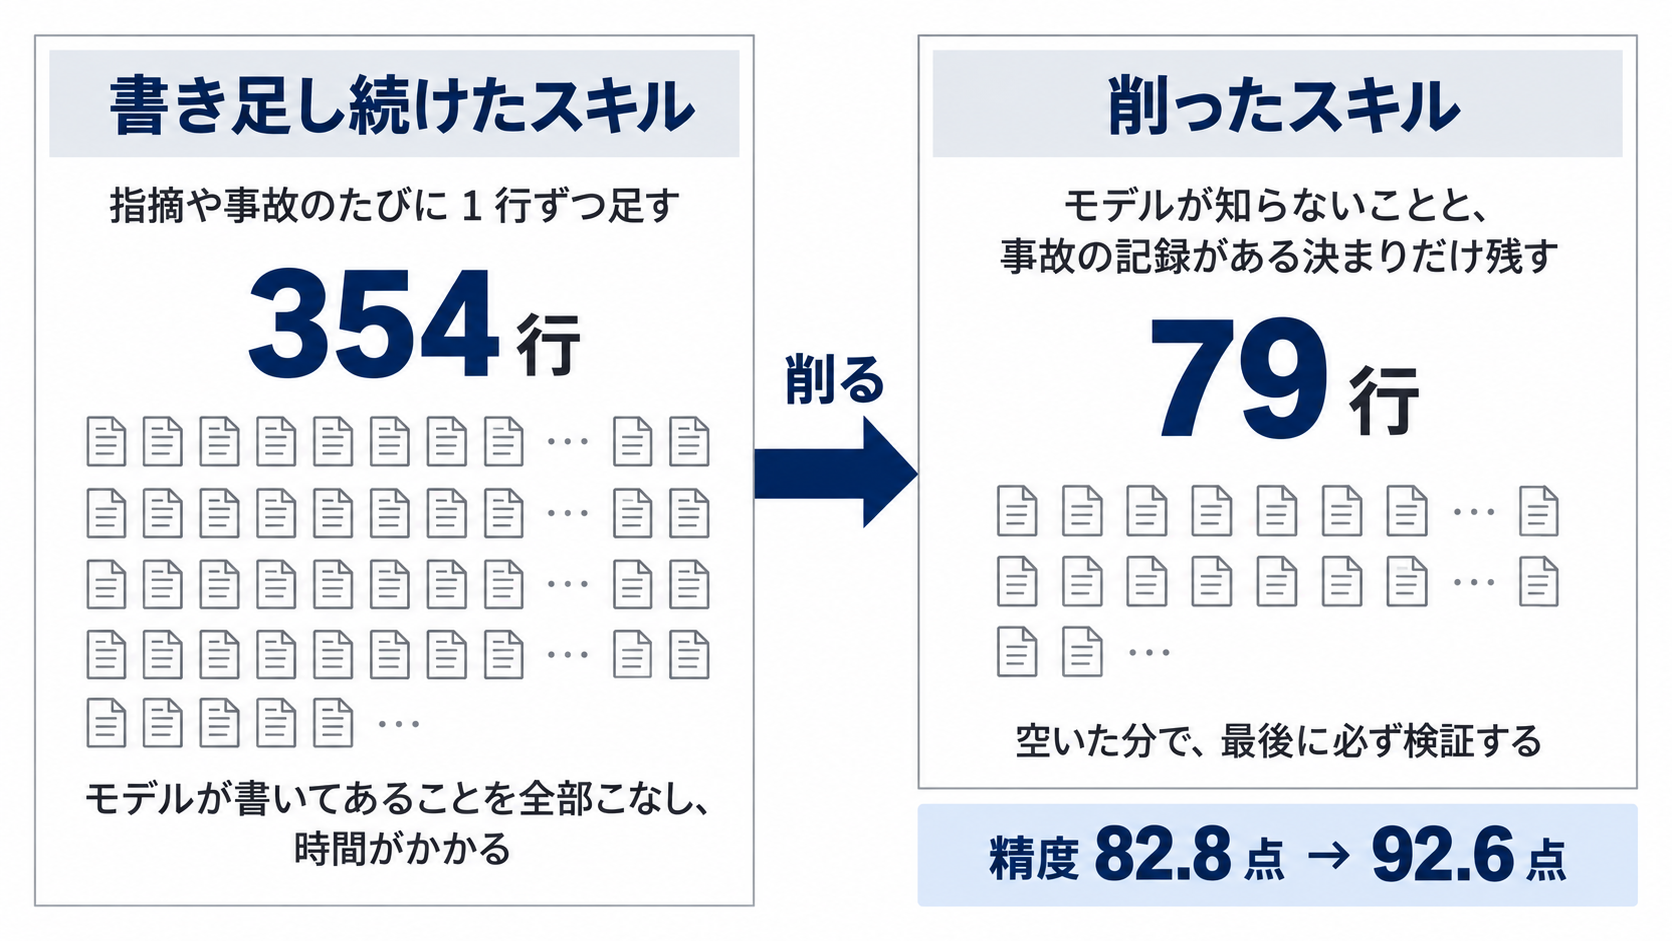
図の精度は、デザインどおりにページを組めているかを、別の AI に 100 点満点で採点させた点数です。
測り方は、後の「精度の測り方」で説明します。
スキルに 1 行足すと、そのときは安心できます。
けれど、足した指示はどれも守られるので、行が増えるほど時間とトークンを使います。
この記事は、そうやって書き足してきたスキルを思い切って削り、分かれていたスキルを 1 つにまとめ直した記録です。
開発者の対談とスキルの書き方のガイド
ルールが増え続けていたところに読んだのが、Claude Code の開発者 Boris Cherny 氏の対談と、Anthropic のスキルの書き方のガイドです。
この 2 つが、削ると決めたきっかけでした。
Boris Cherny 氏は YC の Startup School 2026 での対談で、Opus 5 になって、Claude Code のシステムプロンプトの 80% を削除したと話しています(聞き手は Diana Hu 氏、書き起こしは 2026 年 7 月 27 日に掲載)。
同じ対談で、使う側にも半年ごとにスキルやフックを消して、モデルが何をするか見てみることを勧めています。
下の引用はその書き起こしからです。
And a lot of the stuff in the system prompt was correcting for these behaviors that the model should have known, but it didn’t. Now Opus 5 just does it. So yeah, we deleted 80% of the system prompt.
(訳: システムプロンプトの多くは、モデルが知っているはずなのに知らなかった振る舞いを補正するためのものだった。いまは Opus 5 がそれをそのままやる。だからシステムプロンプトの 80% を削除した。)
And for people that aren’t building agentic products, but are using Claude Code, every six months, delete ..., delete your skills, delete your hooks. See what the model does and it might surprise you.
(訳: エージェントの製品を作っているのではなく Claude Code を使っている人は、半年ごとに、スキルを消し、フックを消してみてください。モデルが何をするかを見ると、驚くかもしれません。)
Anthropic のスキルの書き方のガイドも、短く書く理由を説明しています。
「Claude はすでに非常に賢い」を前提に、モデルが知らないことだけを足し、SKILL.md は簡潔に保つよう書いています。
Default assumption: Claude is already very smart
Only add context Claude doesn't already have.
(訳: 既定の前提: Claude はすでに非常に賢い。Claude がまだ持っていない文脈だけを足す。)
ただし、ガイドは壊れやすく誤りやすい作業には具体的な手順を与えるようにとも書いています。
今回も、テンプレートの対応や色の完全一致のようなこの業務だけの決まりと、事故の記録がある規則は残しました。
モデルが Opus 5.5 に上がったので、指示を減らしても同じものが出せるのではないかと考え、削ることにしました。
どのルールなら削ってよいかを見分けるために、削る前に 2 つのことを調べました。
削る前に調べた 2 つのこと
ルールの出どころ
まず、354 行のルールがどんな経緯で足されたのかを調べました。
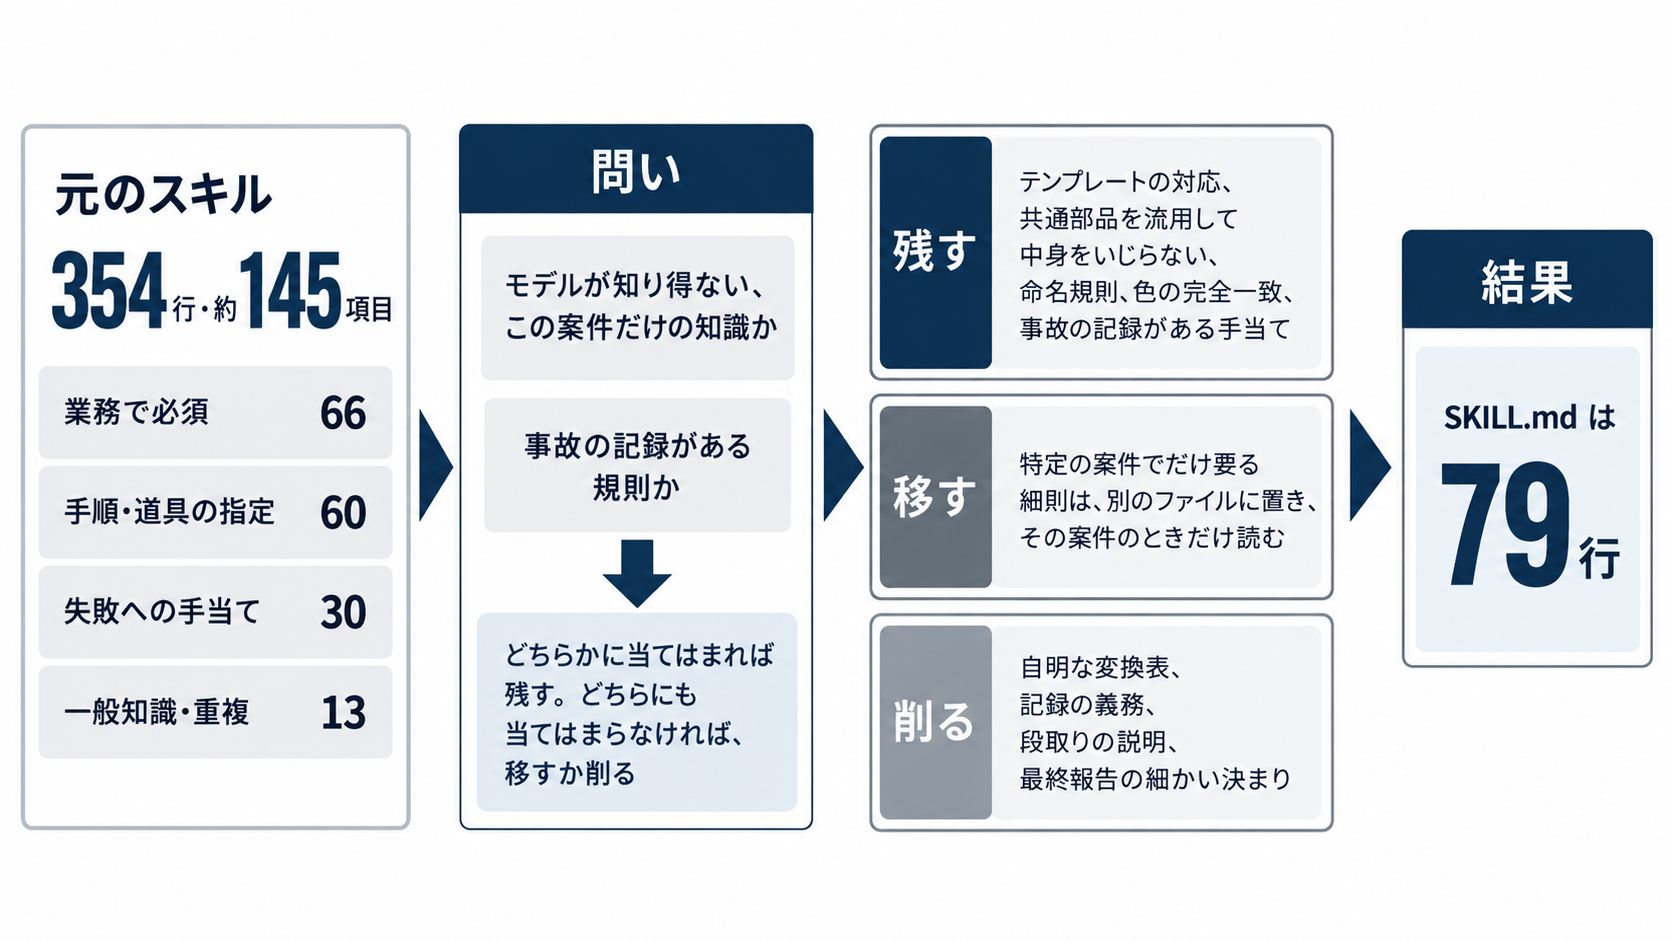
ルールを約 145 項目に分け、行ごとに git の履歴と突き合わせています。
そのうえで、各ルールを 4 つに分けました(1 つのルールが 2 つにまたがることもあります)。
| 分類 | 中身 | 項目数 |
|---|---|---|
| 業務で必須 | この業務だけの決まり。テンプレートの対応、共通部品の使い方、色の完全一致など | 66 |
| 手順・道具の指定 | 何をどの順で、どの道具で行うか | 60 |
| 失敗への手当て | 一度起きた失敗を繰り返さないための規則 | 30 |
| 一般知識・重複 | モデルがもともと知っていること | 13 |
突き合わせて分かったのは、次のことです。
- なぜ足したかを、後から追えないルールが多かった。コミットメッセージに課題の番号は 1 件も無く、事故が書いてあるのは一部のルールだけでした
- 一般知識が混ざっていた。Figma の値を CSS に直す変換表のように、言われなくてもモデルが知っていることを書いていました
- 書いてあるのに効いていないルールがあった。「前の工程を飛ばすと止まる」はずの確かめは、ファイルの探し方の都合で一度も動いていませんでした
出どころを調べた git のコマンド
git log --follow --oneline -- .claude/skills/<スキル名>/SKILL.md   # ファイルの履歴
git blame -c .claude/skills/<スキル名>/SKILL.md                     # 行ごとに、どのコミットで入ったか
git log -1 --format="%B" <commit>                                    # そのコミットで足した理由を読む
git log -S "<ルールの一文>" --oneline                                 # その文を足した・消したコミットを探す
時間の使われ方
次に、テスト 5 本の実行の記録を読みました。
1 本の所要は 28〜59 分でしたが、そのうち HTML と SCSS を書いている時間は 2〜7.5 分だけでした。
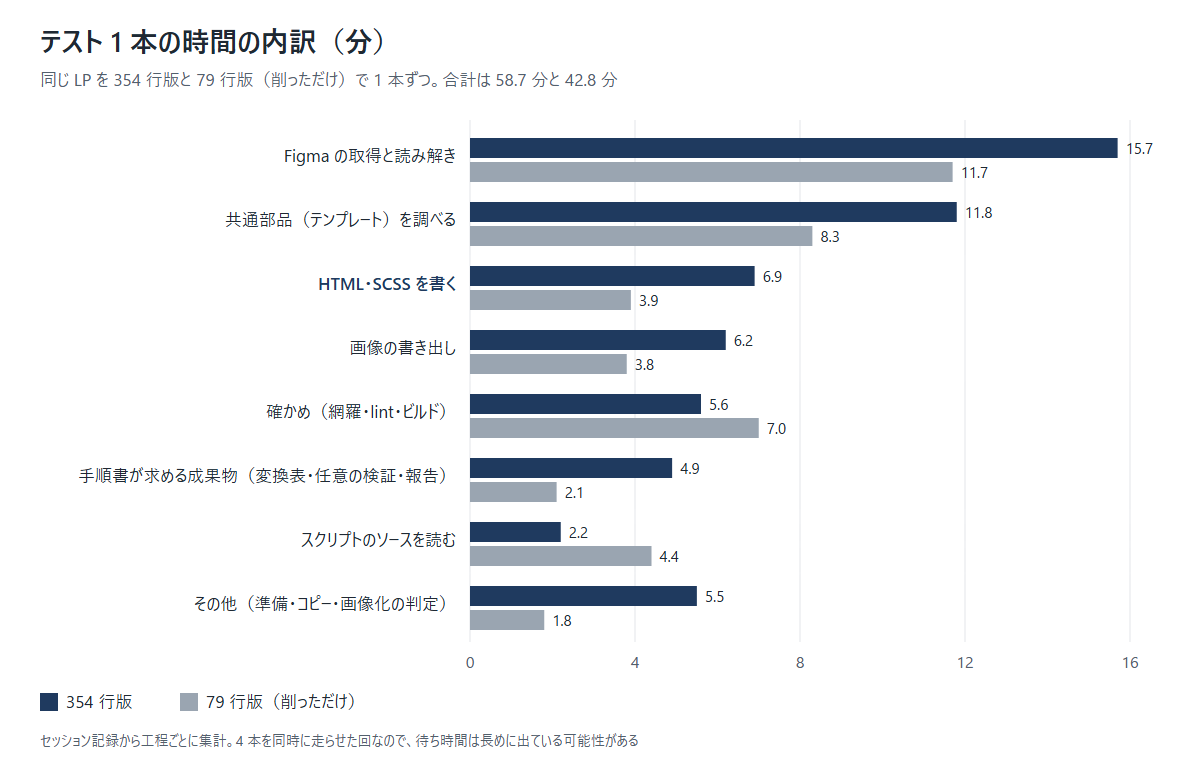
記録を見る限り、時間を食っていたのは手順書を読むことではありませんでした(読み直す動きは 0 回)。
手順書が「作れ」と求めていた変換表・記録・長い報告・自主的な検証(合わせて約 5 分)と、どの回も同じことを調べ直す時間です。
書いてあることを全部こなそうとするぶん、時間がかかっていました。
2 つの調べで、見直すもの(一般知識、理由を追えないルール、手順書が求める成果物、毎回の調べ直し)がはっきりしました。
残すルールの決め方
残すか削るかを決める 2 つの問い
出どころの調べでは、一般知識が混ざっていて、足した理由を追えないルールが多いと分かりました。
そこで、残すか削るかは次の 2 つの問いで決めました。
- モデルが知り得ない、この業務だけの知識か
- 事故の記録がある規則か
どちらかに当てはまるルールは残し、どちらにも当てはまらなければ、削るか、必要なときだけ読む別のファイルに移しました。
残したものと削ったもの
1 つ目の問いで残したのは、次のようなこの業務だけの知識です。
- どのテンプレートを使うかの対応表
- 共通部品を流用して中身をいじらないこと
- レイヤー名の命名規則
- 色の完全一致
- 画像の実寸など
2 つ目の問いで、事故の記録があった手当て(流用の前に部品の種類を読む、余白が親の幅をはみ出すときの扱い、省略されたテキストの全文を取る)も残しました。
削ったのは、変換表の作成、記録の義務、取得手順の段取りの説明、自明な変換表、最終報告の細かい決まり(7 項目を 5 項目に)です。
時間の調べで重かった、手順書が求める成果物(変換表と記録)は、ここで消えています。
たとえば変換表は、Figma のオートレイアウトや余白・影を、flexbox・padding・box-shadow のどれに直すかを 7 つの表に書いたものでした。
Web の実装を知っていれば分かる対応で、モデルも言われなくても知っています。
特定の部品にしか要らない細則は、別のファイルに移しました。
この整理で、SKILL.md は 354 行から 79 行(約 2 万字から約 6 千字)に、関連の md と yaml は 881 行から 377 行になりました。
別のスキルに分かれていた検証は、手順の最後にまとめています。
削る前と後の SKILL.md
ここから実物です。
削る前と後の SKILL.md の中身を、骨組みで示します。
業務に結びつく名前は伏せ、スクリプトの名前は仮の名前に置き換え、一部を省いています。
削った後のほうは、採用した版です。
削る前の Step 1〜9 の手順書
(冒頭の段落と、小見出しの「前提」)
## 事前確認
## Step 1: 前処理(Figma 取得)          ← 約 45 行。取得の段取りと図
## Step 2: テンプレートのコピー
## Step 3: コンポジット判定             ← 画像にする要素の判定と、判断の記録
## Step 4: 画像エクスポート
## Step 5: 変換テーブル作成              ← Figma の値と CSS の対応表を毎回作る
## Step 6: 部品流用(テンプレートから)
## Step 7: HTML 生成                     ← 約 59 行
## Step 8: SCSS 編集
## Step 9: ビルド & 検証                 ← 約 62 行。最後に「確認用の属性を外すか」をユーザーに聞く
## 最終報告
(ほかに辞書 3 本: Figma→CSS の変換表、画像にする要素の目印、部品の対応)
振り返ると、細かく書きすぎていました。
何をどの順で、どの道具で行うかを Step ごとに決め、変換表のようにモデルが知っていることまで書いていました。
削った後の手順書
Figma の指定ノードを、サイトのテンプレートの上に静的 HTML / SCSS で実装する。
ゴールは「Figma の見た目を忠実に再現し、本番の共通 CSS・モジュール・ビルド規約に沿ったコード」。
HTML / CSS の書き方そのものは任せる。以下はこの業務固有の前提と道具。

指定ノード配下はすべて実装対象。テンプレートが一意に決まらないときはユーザーに確認する。
それ以外の判断に迷う点は推奨案で進め、最終報告に書く。

## 道具(scripts/ のスクリプト。uv run で動かす)
| 用途 | コマンド |
|---|---|
| ノードの JSON 取得 | uv run scripts/fetch_node.py <file_key> <node_id> <out.json> --depth N |
| JSON → 読みやすい木構造 | uv run scripts/to_tree.py <in.json> <out.txt> [--max-lines 150] |
| 画像の書き出し | uv run scripts/export_images.py <file_key> <id1>,<id2>,... <img_dir>/ --scale 2 |
| テキストの網羅の確かめ | uv run scripts/check_text.py <html> <figma_dir> |
| ビルド | uv run scripts/build.py <出力先> |
(ほか 7 行)

調べなくてよいこと: (下に載せる)

## 業務固有のルール
- 出力とテンプレート / 部品の流用 / 画像にするもの・しないもの / テキスト / HTML / SCSS

## 仕上げ(必須・省略しない)
1. 確かめ(すべて通るまで直す): テキストの網羅 → SCSS の lint → ビルド
2. 検証と修正: docs/verify.md の手順で Figma と見比べて直す

## 最終報告
冒頭の段落で「HTML / CSS の書き方そのものは任せる」と明記し、モデルが得意なことと、この業務だけの知識の間に線を引きました。
作業の段取りを細かく書くのはやめ、道具の表と、この業務の決まりと、仕上げの順番だけに絞っています。
「調べなくてよいこと」の段落
実行の記録では、5 本すべてが手順書に無い同じ調べものを毎回やり直していました。
そこで、調べなくてよいことを 1 段落で書きました。
調べなくてよいこと: スクリプトの中身(使い方はここ、直し方は失敗時の出力にある)。
業務で空欄と決まっている値は空のままでよい。テキストにゼロ幅スペースは要らない。
ビルドが index.html にクエリ文字列を付け、ルートに別の HTML を作るのはテンプレートの仕様。
手順にない追加の検証(HTML の lint など)はしない。
モデルは気になったことを、頼まれなくても確かめにいきます。
確かめなくてよいと分かっている所は、そう書いておくのが早道でした。
手順書は短くなりました。
次は、短くした版で精度が落ちていないかを確かめました。
精度の測り方
この記事の「精度」は、Figma のデザインどおりにページを組めているか、です。
公開済みの LP 5 件のデザインを材料に、プロンプトとモデルを固定し、スキルの版だけを変えて組ませました。
比べたのは、元の 354 行の版と、削って検証をまとめた 3 つの版(136 行・79 行・35 行)です。
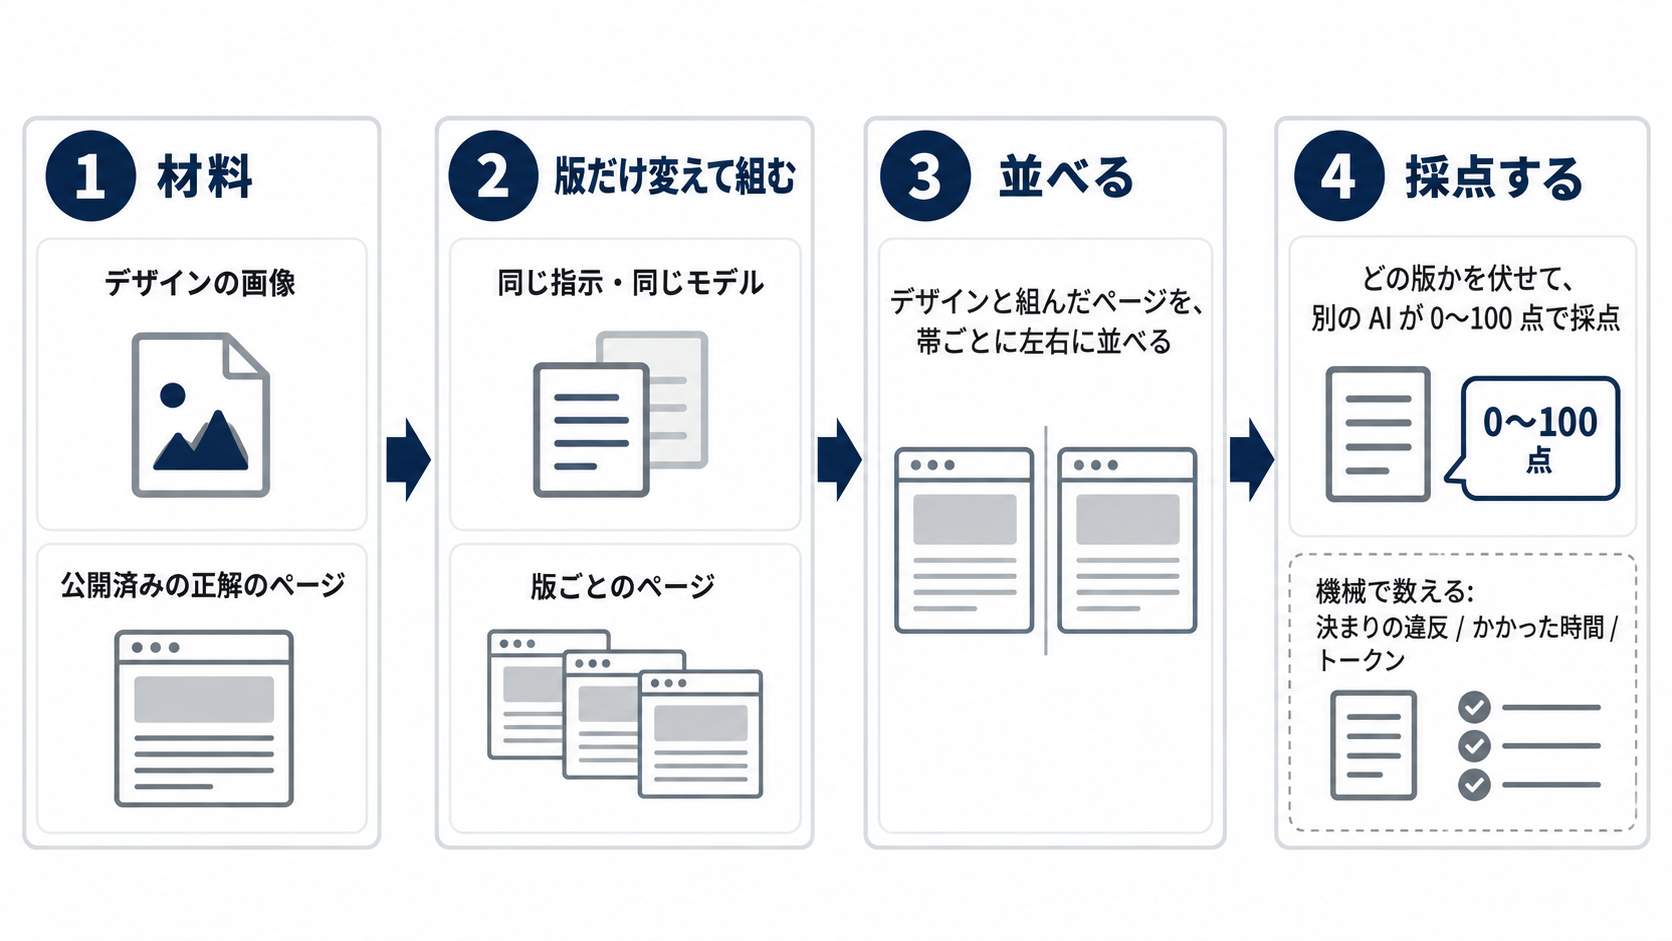
測ったのは次の 3 つです。
- 採点: 組んだページをブラウザで描画し、デザインの画像と、上からセクションごとに区切って左右に並べる。その画像を別の Claude のセッション(画像を読むことしかさせない)に見せ、どの版の出力かを伏せたまま、デザインにどれだけ近いかを 0〜100 点で付けさせる。この記事の点数は、すべてこの採点です
- 業務の決まりの違反: リンク先が無いときの書き方のような決まりを守れているか。機械で数える
- 所要時間と出力トークン
精度とプロンプトの量の開きが最大の所を、夜のあいだに探させた
探したのは「開き」がいちばん大きい所
どこまで削るかを人が決めるのは大変です。
1 本 30 分前後かかるテストを、版と案件の組み合わせごとに回すと、数十本になります。
探したいのは、精度を上に、プロンプトの量を下に取って並べたとき、2 つの開きがいちばん大きくなる版です。
削るほどプロンプトの量は減りますが、削りすぎれば精度が落ちて、開きはまた狭まるはずです。
その開きが最大になる所を、エージェントに探させました。
寝る前に送ったプロンプト
削る版づくりと評価の大半は、10 月 7 日の夜から翌朝にかけてエージェントに任せました。
寝る前に、見張り役のエージェント(T3 Code のスレッド)へ送ったのが次のプロンプトです。
実物から、業務の名前をぼかし、同じ夜に頼んだ別の作業(新しいスキルづくり)を省いた抜粋です。
言い回しは、送ったときのままです。
(前略)
2. 検証のスキルのリファクタリング
検証用のスキルですが、実行自体が形骸化しており、Git の最終更新日も 6 月 4 日と随分古い状態です。現状は実装のスキルを使った後に任意で検証のスキルを使う設計思想にしていますが、実際には使われていません。
3. 実装のスキルと検証のスキルの結合(マージ)
上記のとおり検証のスキルが単体で使われず形骸化しており、セットで運用することができていない状況です。そのため、実装のスキルの中にステップとして組み込み、半ば強制的に検証の仕組みを通すことで、より精度を上げていきたいと考えています。
(中略)

あなたにこれからやってほしいこと:

まずはリファクタリングと結合の件です。
実装と検証のスキルを作った当初は、Opus 4.6 など今でいうレガシーなモデルを使っていました。しかし現在では Opus 5.5 が登場し、デザインの再現度や思考力が大幅に向上しています。モデル単体でも、Figma のデザインを渡して「ウェブ標準で組んで」と指示すれば、ある程度の品質で組み上げてくるはずです。

昨今は Claude Code や Anthropic 社(Claude 社)も言及しているように、スキル側で作り込まずモデル性能に寄せていく(余計なプロンプトを削る)流れになっています。現在の実装のスキルはかなり詳細にガチガチのプロンプティングルールを定めていますが、業務特有のビジネスロジックや制約上どうしても必要なものを除けば、普遍的なコーディングルールなど、モデル性能でカバーできる無駄なルールも一部存在しているはずです。

そうしたルールやスキルの一部を解いてあげる(引き算する)リファクタリングを行ってほしいと考えています。

進め方としては:
• 現在のもので作った HTML コードやデザイン再現性を基準に、何ラウンドかテストを回してください。
• スキルを引き算して減らしていき、精度が最も高くなるポイントを見極めてフィックス版としてください。
• スキルの記述量を減らすことで余裕ができるため、その中に検証をステップとして組み込み、マージしてください。
(中略)

今夜の作業の進め方について:
今夜これから私は寝るので、自律的に進めておいてください。あなたは監督者(モニター)として朝まで実行を見張る役割をお願いします。

1. ブランチとコミット:
作業は別ブランチを切り、各種作業を行ってください。ローカルリポジトリへのコミットまでは進めて構いませんが、プッシュは一旦行わないでください。
(中略)
3. 実装と検証のスキルのリファクタリング:
テスト用の案件をいくつか特定し、Figma のデザインと正解の実装 HTML のデザイン性が一致しているものを揃えてください。現在のスキルで実行した出力精度を確認した上でリファクタリングを開始し、精度の向上や減退を評価できるようにしてください。
(中略)

今夜は他の作業を行わないため、ハードに複数エージェントを立ち上げ、指示した内容をひたすら自動で繰り返し実行してスキルの精度を高めてください。これ以降は私の承認が取れないので、すべて自主的に進めて構いません。トークン消費量は一切気にしなくていいので、Claude Opus 5.5 を大量に立ち回して作業してください。

朝起きたときに、各スキルの精度が大幅に向上していること(後略)
要になるのは「スキルを引き算して減らしていき、精度が最も高くなるポイントを見極めて」の 1 文です。
どの段階まで削るか、何で測るかは書いていません。
そこは、エージェントが計画を立てるところから任せました。
エージェントが組んだ段取り
見張り役は、このプロンプトから作業の計画を書き、テストを回す仕組みを用意しました。
評価役と版ごとのテストは、herdr(エージェントの状態を持つターミナル)のタブに並べて回しています。
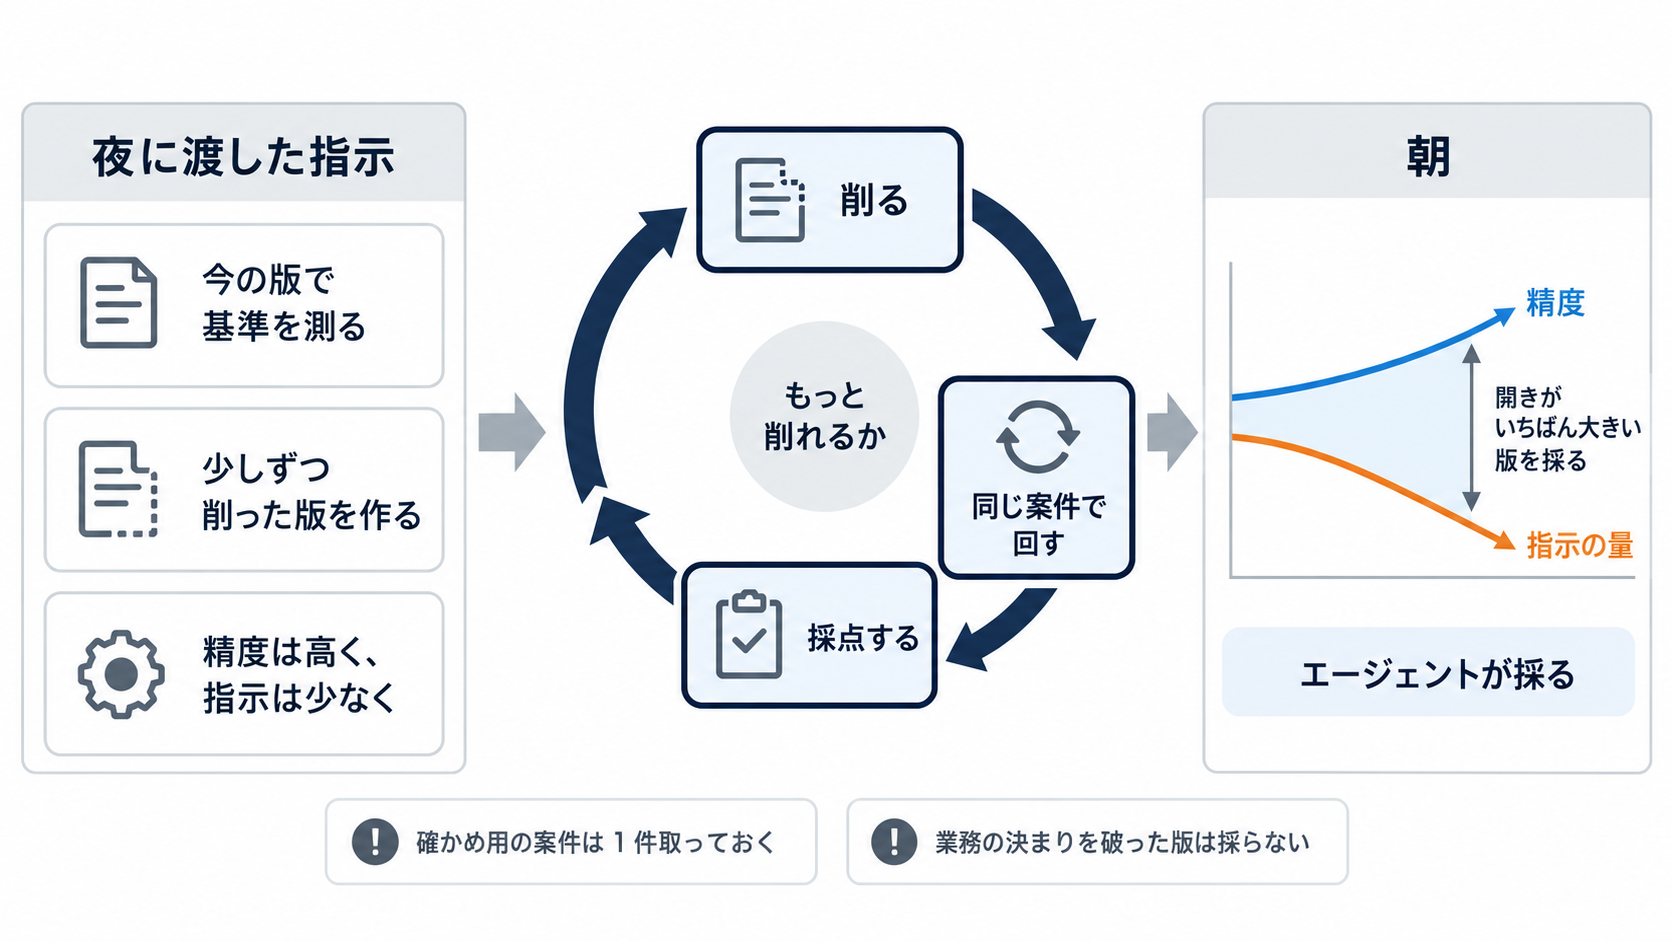
計画のうち、効いていたのは次の 5 つです。
- テスト案件をそろえる: Figma のデザインと、公開済みの正解の HTML の見た目が一致している LP を選ぶ
- 基準を先に測る: 削る前に、いまの版で各案件を回して点を取っておく
- 削り方を段階に分ける: 一般的な所と重複を消すだけの版から、業務で必須の決まりと最低限の手順だけの版、手順の段取りまでモデルに任せる版まで作る
- 採る条件を先に決める: 基準の版と同等以上の精度で、業務の決まりの違反がないこと。この条件を満たしたまま削れる所までを、引き算の限界とする
- 確かめ用の案件を取っておく: 案件の 1 件は引き算の調整に使わず、最後の確かめに回す。調整に使った案件だけに合わせ込まないため
テストのプロンプトは、全部の版で同じにしました。
夜は質問に答える人がいないので、迷ったら自分で選び、選んだ内容を報告に書くよう最初に断っています。
/<実装のスキル> <Figma の URL>

(自動評価の実行です。ユーザーは不在で質問に答えられません。確認が必要な場面では推奨または最も妥当な選択肢を自分で選んで進め、選んだ内容を最終報告に書いてください。data-figma-id は削除せず残してください。ブラウザでのプレビューは不要です。)
翌朝 7 時 50 分には、版ごとの点数の表と、採用の条件に照らして 79 行の版を採るという結論がそろっていました。
朝の私は、その表と条件を照らして確かめるだけで済みました。
エージェントを並べて回す仕組みは、次の記事に書いています。
https://trellis-grow.com/tech/2026/10/t3code-herdr-mobile-agents/スマホで開く
スキルを削るとき、いちばん効いたのがこの回し方でした。
ルールの出どころを調べた段階では「攻めても約 150 行」と見ていましたが、測りながら削ると 79 行で足りました。
削る量を勘で決めずに済み、測った数字で止められます。
結果: 4 分の 1 の長さで、精度は約 10 点上がった
版ごとの採点・所要・トークン
| 版 | 採点の平均 | 所要(分) | 出力トークン |
|---|---|---|---|
| 354 行(元の版) | 82.8 | 32.6 | 126k |
| 136 行 | 91.3 | 28.5 | 102k |
| 79 行(採用) | 92.6 | 29.3 | 102k |
| 35 行 | 92.7 | 28.0 | 104k |
公開済みの LP 5 件で、削った版は 3 本ずつ(35 行の版は 2 本ずつ)、元の版は 2 本ずつ回した平均です。
削った版には、評価の途中で見つけたスクリプトの直しも入っています。
79 行の版は、元の版の 4 分の 1 以下の長さで、出力トークンも約 2 割少ないまま、採点は約 10 点上がりました。
所要時間も、新しく足した検証の時間を含めて短くなっています。
開きがいちばん大きかったのは 79 行の版
この表を、精度を上に、プロンプトの量を下に取って並べると、次のようになります。
プロンプトの量は SKILL.md の行数で、元の版を 100 としています。
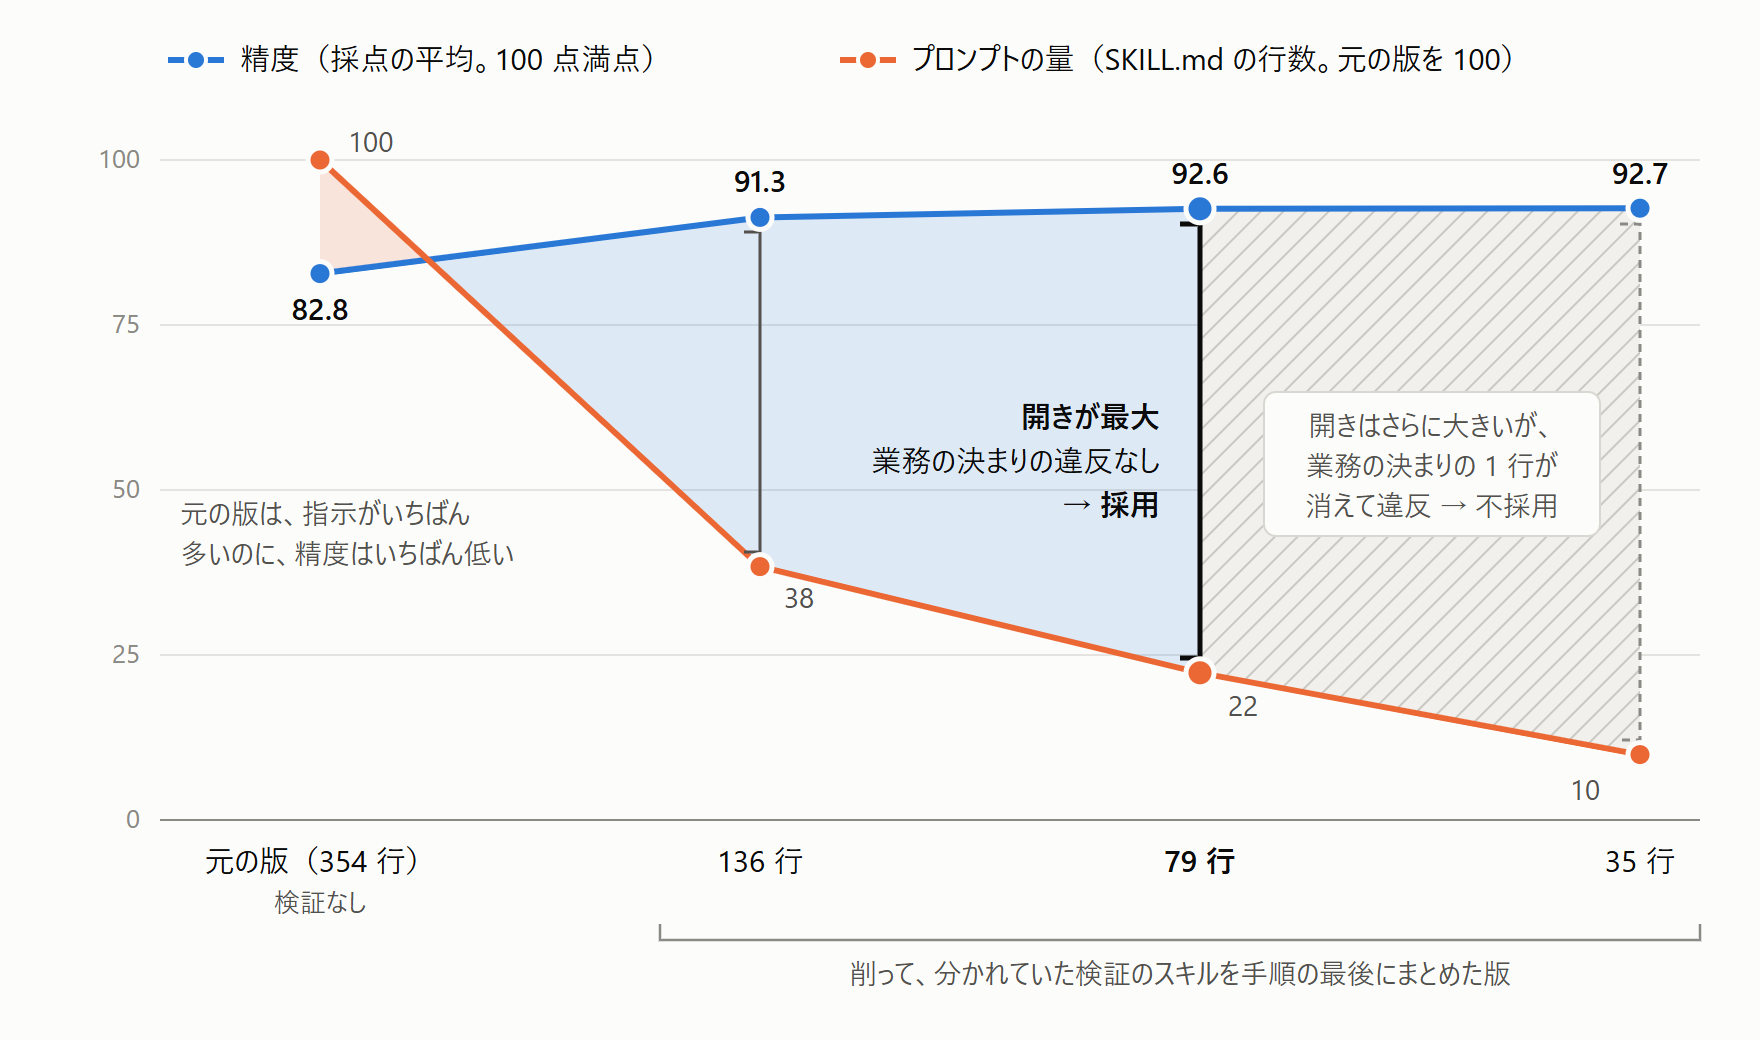
削るほど、2 本の線の開きは広がりました。
精度は検証をまとめた所で上がり、そこからはほぼ横ばいのまま、プロンプトの量だけが減っていったからです。
開きだけを見れば、35 行の版がいちばん大きく見えます。
ところが 35 行の版では、「リンク先が無ければ # にする」という業務の決まりの 1 行が消え、リンク先に仮の文字が残った出力がありました。
業務の決まりの違反は採点には出ないので、採る条件に「違反がないこと」を入れておいたのが効きました。
違反のない版の中で開きが最大だったのが、79 行の版です。
担当のエージェントが書いた報告
表の数字は、評価を担当したエージェントが朝までに書いた報告から取りました。
V0 が元の版、確定版が 136 行、L3 版が 79 行、L4 版が 35 行の版にあたります。
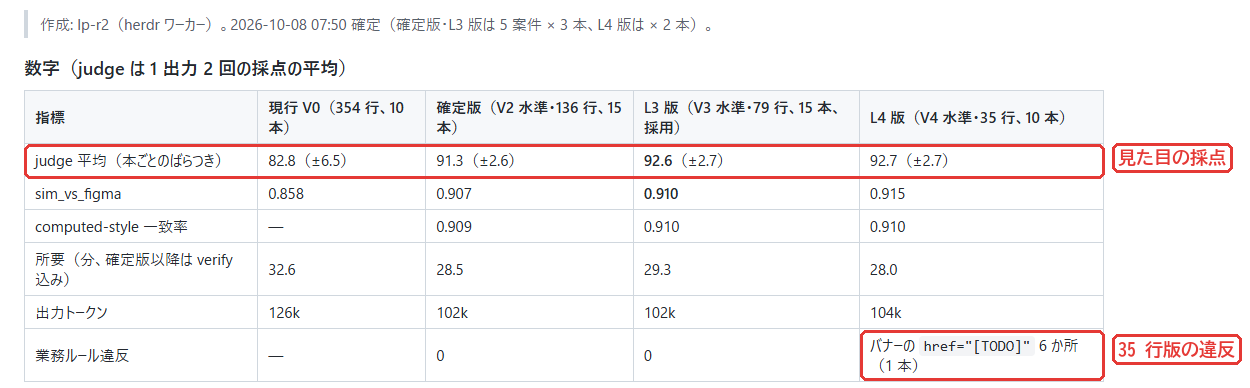
まとめ: 削って、まとめて、開きが最大の所で止める
指摘のたびに書き足してきたスキルを、モデルが知らないことと事故の記録がある決まりだけに削り、分かれていた検証のスキルを手順の最後にまとめました。
4 分の 1 の長さになっても、精度は 82.8 点から 92.6 点に上がっています。
- 何を残したか: 「モデルが知り得ない、この業務だけの知識か」「事故の記録がある規則か」のどちらかに当てはまるものだけ。一般知識を消しても精度は落ちなかった
- どう決めたか: 精度は高く、プロンプトの量は少なく。その開きがいちばん大きい版を、夜のあいだにエージェントに「削っては測る」で探させた
- 何に気をつけるか: 削りすぎると、業務の決まりの 1 行まで落ちる。採点に出ない違反は別に数えて、その版を採らない
指示を足すと、そのときは安心できます。
でも足した指示はどれも守られるので、そのぶん時間とトークンを使います。
いまは新しい 1 文を足す前に、それがモデルの知らないことか、事故の記録があることかを確かめるようにしています。
まだ残っている限界
- 「354 行のまま、検証とスクリプトの直しだけを入れた版」は測っていません。約 10 点のうち、短くしたことの効き目は分けられていません
- 比べたのはすべて Opus 5.5 です。前のモデルでは回していないので、モデルが新しくなったから削れたのかは確かめていません
- テストの LP はすべてスマホ向けだけの作りでした。PC とスマホで切り替わる作りは確かめていません
- いまの SKILL.md は、新しい案件で足りなかった決まりを 1 文ずつ足すなどして、95 行・約 1 万字になっています。一度削れば終わりではなく、足すたびに 2 つの問いに照らす必要があります
Trellis のこと
Trellis は、福岡でホームページの制作と、AI による業務の自動化に取り組んでいます。
記事は Zenn と、Trellis のサイトのブログの両方に載せています。